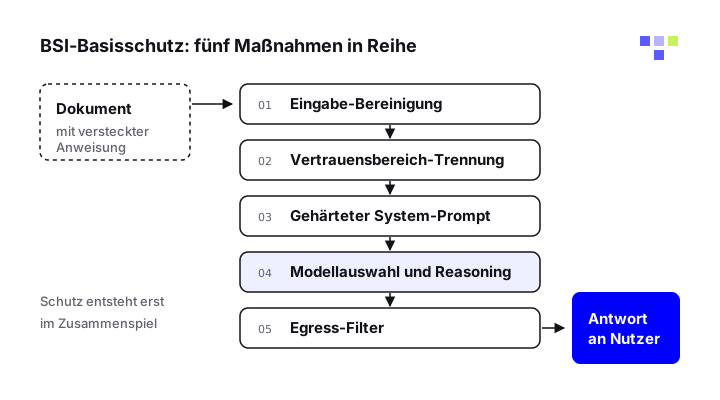
Im September 2026 hat das Bundesamt für Sicherheit in der Informationstechnik den BSI-Basisschutz gegen Indirect Prompt Injection in dokumentbasierten LLM-Chats veröffentlicht, als Version 1.0 vom 14. September 2026. Das Papier beschreibt fünf Basismaßnahmen, die das BSI aus eigenen Red-Teaming-Tests abgeleitet hat, und stellt den Code dazu offen bereit. Hier erfahren Sie, was die Maßnahmen tun, wie Sie sie umsetzen und wo sie bei KI-Agenten an ihre Grenzen stoßen.
Was ist der BSI-Basisschutz gegen Indirect Prompt Injection?
Das Papier betrifft Chats, in die Nutzer Dokumente hochladen. Der Angriff: Jemand schreibt Anweisungen in ein Dokument, etwa mit unsichtbaren Unicode-Zeichen oder weißer Schrift auf weißem Grund, in der Hoffnung, dass der Chatbot ihnen folgt. Zum Inhalt zählt das BSI ausdrücklich auch Metadaten, Annotationen und Kommentare. Das Dokument steht dabei stellvertretend für jede externe Datenquelle.
Das BSI hat mehrere solcher Chats im Red Teaming untersucht. Die wiederkehrende Schwäche: Dokumentinhalte landen ungefiltert im Prompt und sind nicht klar von der Anfrage des Nutzers getrennt. Besonders kritisch waren Datenabflüsse über Exfiltrationslinks. Den Kern des Problems fasst das BSI so: „Ein LLM kann alleine nicht zwischen User-Prompt, Systemanweisungen, externen Anweisungen und Daten unterscheiden.“
Parallel gibt es ein GitHub-Repository mit einem Test-Labor für alle fünf Maßnahmen, das sich einzeln zu- und abschalten lässt. Es enthält außerdem einen Agenten-Skill, der einen Dokumenten-Chat darauf prüft, ob die fünf Maßnahmen umgesetzt sind. Wie der Angriff im Ganzen abläuft, erklärt der Leitfaden zur indirekten Prompt Injection.
Die fünf Maßnahmen des BSI-Basisschutzes im Überblick
Die Maßnahmen setzen an verschiedenen Stellen der Verarbeitungskette an, vom Hochladen des Dokuments bis zur Übergabe der Antwort. Das BSI betont, dass der Schutz erst im Zusammenspiel entsteht, und empfiehlt, alle fünf anzuwenden.
| Nr. | Basismaßnahme | Wo sie ansetzt | Was sie tut |
|---|---|---|---|
| 1 | Eingabe-Bereinigung | vor der Übergabe an das Modell | entfernt Verschleierungen auf Zeichenebene |
| 2 | Vertrauensbereich-Trennung | beim Zusammenbau des Prompts | markiert fremde Inhalte als Daten |
| 3 | Gehärteter System-Prompt | in der Systemanweisung | spricht Dokumenten jede Anweisungsbefugnis ab |
| 4 | Modellauswahl und Reasoning | am Modell selbst | wehrt rein sprachlich getarnte Angriffe ab |
| 5 | Egress-Filter | vor der Ausgabe an den Nutzer | stoppt Datenabfluss und auffällige Antworten |
Die Maßnahmen sind miteinander verzahnt. Eine gemeinsame Sitzungs-ID koppelt System-Prompt und Vertrauensbereich-Trennung, ein Canary-Token und typische Formulierungen aus dem System-Prompt dienen dem Egress-Filter als Erkennungszeichen. Wer eine Maßnahme weglässt, öffnet laut BSI Wege, die die anderen nicht abdecken.
Eingabe bereinigen und Vertrauensbereiche trennen
Die Eingabe-Bereinigung zerlegt eine PDF-Datei in Textkörper, Metadaten, Gliederung und Annotationen. Jeder Teil wird normalisiert und per regulärem Ausdruck gefiltert. Entfernt werden unter anderem unsichtbare Unicode-Tag-Zeichen, Steuerzeichen, die die Schreibrichtung umkehren, und ungewöhnliche Leerzeichen. Optisch ähnliche Zeichen wie ein kyrillisches „a“ werden auf ihre lateinische Form zurückgeführt.
Gefälschte Rollen-Trennzeichen wie <|system|> ersetzt der Filter durch [FILTERED]. Tags, mit denen ein Dokument den markierten Bereich verlassen will, werden zu harmlosem Text. Bekannte Auslöser soll ein Filter laut BSI zusätzlich markieren und protokollieren. Würde er sie löschen, wäre der Angriff für die Auswertung verloren.
Die Vertrauensbereich-Trennung packt den bereinigten Inhalt in einen äußeren Block <untrusted_document> und versieht ihn bei jeder Anfrage mit einer neuen Zufalls-ID. Ein Angreifer müsste diese ID kennen, um den Block zu schließen. Die ersten und letzten zweihundert Wörter des Dokuments werden zusätzlich mit dem Zeichen „^“ durchsetzt. Ein Vortext, ein Nachtext und eine Erinnerung am Ende der Nutzereingabe kennzeichnen den Inhalt dreifach als Daten.
System-Prompt härten, Modell wählen, Ausgabe filtern
Der gehärtete System-Prompt besteht im Beispiel des BSI aus acht Teilen. Er legt die Rolle des Modells unveränderlich fest, ordnet System-Prompt, User-Prompt und Dokument nach Priorität und gibt dem Dokument keine Anweisungsbefugnis. Dazu kommen harte Verbote wie keine Exfiltrationslinks, Negativbeispiele für Täuschungen und ein geheimes Canary-Token, das je Sitzung neu entsteht. Im Zweifel gilt ein Inhalt als Daten.
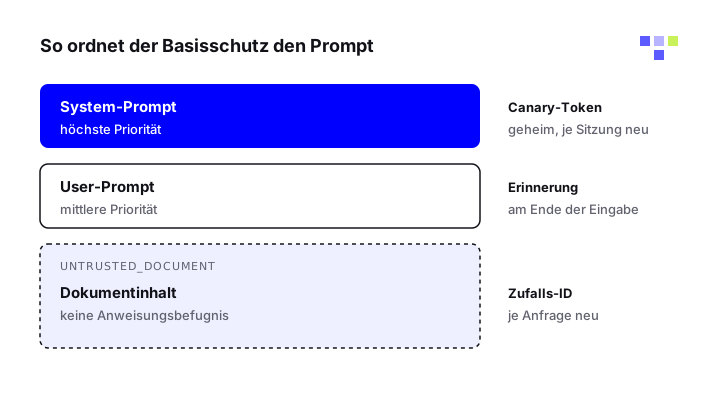
Das Dokument steht ganz unten: keine Anweisungsbefugnis, markiert mit einer Zufalls-ID je Anfrage.
Bei Modellauswahl und Reasoning verweist das BSI auf Benchmarks wie BIPIA und InjecAgent. Einen vorgeschalteten Denkschritt nennt es einen der wirksamsten Hebel des gesamten Basisschutzes. Das Reasoning soll der Nutzer nicht sehen, weil es selbst zum Angriffsweg werden kann.
Der Egress-Filter prüft jede Antwort in vier Schritten: Taucht das Canary-Token auf, auch mit Leerzeichen, in Base64 oder hexadezimal? Enthält die Antwort Teile des System-Prompts? Gibt es Anzeichen, dass das Modell eine fremde Rolle übernommen hat? Stecken Markdown-Bilder, HTML-Bilder oder Links auf nicht freigegebene Adressen darin? Das BSI empfiehlt eine Liste erlaubter Links und ersetzt eine kritische Antwort komplett durch eine neutrale.
Wo der Basisschutz an Grenzen stößt
Das BSI ist deutlich: Der Basisschutz wirkt gegen offensichtliche und leicht ausnutzbare Angriffswege, gewährleistet aber keinen vollständigen Schutz. Indirect Prompt Injection gilt weiter als nicht abschließend lösbar. Schon 2023 hatte das BSI gewarnt, dass keine verlässliche Gegenmaßnahme das Problem ganz beseitigt.
Die Schwachstellen benennt das Papier selbst. Inhaltlich argumentierende Angriffe in sauberem Text passieren die Eingabe-Bereinigung unverändert. Hierarchien im Prompt lassen sich laut einer zitierten Studie umgehen. Benchmarks messen Stichproben und beweisen keine Robustheit im Einzelfall. Und gezielt entwickelte Abwehr lässt sich durch angepasste Angriffe aushebeln.
Wichtig für Agenten: Das Papier behandelt Chats, die antworten. Mit der Entwicklung solcher Chats hin zu KI-Agenten empfiehlt das BSI dringend, sicherheitskritische Aktionen von einem Menschen bestätigen zu lassen und fortlaufend zu protokollieren und auszuwerten. Wie eine solche Bestätigung im Alltag funktioniert, zeigt der Leitfaden zu Human in the Loop.
Was Unternehmen mit dem BSI-Basisschutz jetzt tun
Nutzen Sie den BSI-Basisschutz gegen Indirect Prompt Injection als Prüfliste für jede Anwendung, die fremde Dokumente, Mails oder Webseiten an ein Sprachmodell gibt. Das BSI versteht die Maßnahmen als Fundament, nicht als hinreichende Schutzbedingung, und verlangt einen wiederkehrenden Kreislauf aus Red Teaming, Schließen von Lücken und Nachschärfen.
- Bestehende Dokumenten-Chats mit dem Agenten-Skill aus dem BSI-Repository gegen die fünf Maßnahmen prüfen.
- Das Labor nur lokal betreiben: Laut Repository hat es keine Anmeldung und soll nicht öffentlich erreichbar sein.
- Die Liste erlaubter Links und den System-Prompt an den eigenen Einsatz anpassen; maßgeblich ist laut BSI die Struktur des System-Prompts.
- Für Agenten zusätzlich Freigaben vor sicherheitskritischen Aktionen und eine laufende Protokollierung einrichten.
Eine Schritt-für-Schritt-Anleitung über Chats hinaus bietet der Leitfaden Prompt Injection verhindern. Welche weiteren Papiere das BSI zu KI veröffentlicht hat, steht in der Übersicht BSI und KI.
Den Hintergrund erklärt der Leitfaden Indirekte Prompt Injection im Bereich Angriffe.
Quellen
- Basisschutz gegen Indirect Prompt Injection in dokumentbasierten LLM-Chats, Bundesamt für Sicherheit in der Informationstechnik (BSI)
- Basisschutz gegen Indirect Prompt Injections in dokumentbasierten LLM-Chats, Version 1.0 (PDF), Bundesamt für Sicherheit in der Informationstechnik (BSI)
- baseline_defense_lab_indirectPromptInjections, BSI auf GitHub
- Evasion-Attacks auf LLMs: Gegenmaßnahmen in der Praxis, Bundesamt für Sicherheit in der Informationstechnik (BSI)
- Indirect Prompt Injections: Intrinsische Schwachstelle in anwendungsintegrierten KI-Sprachmodellen, Bundesamt für Sicherheit in der Informationstechnik (BSI)
- OWASP Top 10 for LLM Applications 2026, OWASP GenAI Security Project