Kurz gesagt
Die OWASP Top 10 für LLM-Anwendungen 2026 erschienen am 3. August 2026. Sie nennen zehn Risiken, angeführt von Prompt Injection (LLM01), der Offenlegung sensibler Daten (LLM02) und zu weitreichender Handlungsfreiheit (LLM03, Excessive Agency). Die Liste gilt für Modelle als Bauteil einer Anwendung. Für KI-Agenten, die selbst handeln, hat OWASP eine eigene Top 10 für agentische Anwendungen.
Was ist die OWASP Top 10 LLM?
Die OWASP Top 10 LLM ist eine Rangliste der zehn kritischsten Sicherheitsrisiken für Anwendungen, die auf großen Sprachmodellen (LLMs) aufbauen. Herausgeber ist das OWASP GenAI Security Project, an dem Entwickler, Datenfachleute und Sicherheitsfachleute mitarbeiten. Jeder Eintrag beschreibt das Risiko, typische Beispiele, Angriffsszenarien und Gegenmaßnahmen.
Die aktuelle Ausgabe trägt die Jahreszahl 2026 und ist auf den 3. August 2026 datiert. Sie löst die Ausgabe 2025 ab, deren Kennungen wie LLM01:2025 Sie noch in vielen Texten und Prüfberichten finden. Achten Sie beim Zitieren deshalb auf die Jahreszahl hinter der Nummer, denn mehrere Einträge haben ihren Platz gewechselt.
Neu ist die Methode. Bisher beruhte die Liste allein auf der Einschätzung von Fachleuten. Für 2026 hat das Projekt nach eigenen Angaben 7.714 öffentlich dokumentierte Vorfälle gesammelt und 6.639 davon automatisch eingeordnet. Die Abstimmung der Community zählt zu drei Vierteln, die Vorfallsdaten zu einem Viertel.
Die zehn Risiken der OWASP Top 10 LLM 2026
Die Tabelle fasst jeden Eintrag der Ausgabe 2026 in einem Satz zusammen und nennt die Gegenmaßnahme, die OWASP für den Unternehmenseinsatz am stärksten betont. In Klammern steht der Platz in der Ausgabe 2025.
| Nummer | Name | Was passiert | Wichtigste Gegenmaßnahme |
|---|---|---|---|
| LLM01 (2025: LLM01) | Prompt Injection | Eingeschleuster Text in Eingaben, Dokumenten, Bildern, Werkzeugausgaben oder Gedächtnis verändert das Verhalten des Modells. | System so bauen, dass eine gelungene Injection keinen Schaden anrichtet: Rechte begrenzen, Ausgaben in eigenem Code prüfen. |
| LLM02 (2025: LLM02) | Sensitive Information Disclosure | Vertrauliche Daten fließen über Antworten, Werkzeugargumente, Protokolle oder abgerufene Textstellen ab. | Berechtigungen schon bei der Suche im Index prüfen, nur nötige Daten an Anbieter senden, keine Geheimnisse in Systemprompts. |
| LLM03 (2025: LLM06) | Excessive Agency | Ein Agent hat zu viele Werkzeuge, Rechte oder Freiheiten und richtet nach einer falschen Ausgabe Schaden an. | Werkzeuge und Rechte auf das Nötige kürzen, Aktionen im Kontext des Nutzers ausführen, Freigabe für folgenreiche Schritte. |
| LLM04 (2025: LLM03) | Supply Chain | Fremde Modelle, Datensätze, Adapter oder Plattformen sind manipuliert oder fehlerhaft. | Quellen und Lieferanten prüfen, signiertes Verzeichnis aller Komponenten führen, Modelle vor dem Einsatz testen. |
| LLM05 (2025: LLM04) | Data and Model Poisoning | Manipulierte Trainings-, Feinabstimmungs- oder Einbettungsdaten bauen Hintertüren oder Verzerrungen ein. | Herkunft der Daten nachverfolgen, eingehende Daten prüfen, Modelle laufend mit gezielten Angriffen testen. |
| LLM06 (2025: LLM10) | Unbounded Consumption | Angreifer lösen teure Rechenlast aus, legen den Dienst lahm oder kopieren das Modell über viele Anfragen. | Feste Kostenobergrenzen, Begrenzung der Anfragen und Abbruchschalter für Agenten-Schleifen. |
| LLM07 (2025: LLM09) | Misinformation | Falsche, aber glaubwürdige Ausgaben fließen in Entscheidungen oder lösen Aktionen aus. | Aussagen vor der Aktion gegen verlässliche Quellen prüfen, bei folgenreichen Schritten Freigabe verlangen. |
| LLM08 (2025: LLM07) | Hidden Context Exposure | Systemprompt, Werkzeugschemata oder interne Regeln werden ausgelesen und erleichtern weitere Angriffe. | Keine Zugangsdaten in versteckten Kontext legen, Berechtigungen außerhalb des Modells durchsetzen. |
| LLM09 (2025: LLM08) | Vector and Embedding Weaknesses | Schwächen der Vektorsuche, etwa in RAG-Systemen, führen zu Datenlecks zwischen Mandanten oder gesteuerten Antworten. | Zugriffsrechte in der Vektorsuche durchsetzen, Quellen authentifizieren, Daten nach Vertrauensstufe trennen. |
| LLM10 (2025: LLM05) | Improper Output Handling | Modellausgaben gelangen ungeprüft in Browser, Datenbanken oder Terminals und lösen dort XSS, SSRF oder Codeausführung aus. | Das Modell wie einen nicht vertrauenswürdigen Nutzer behandeln: Ausgaben kodieren, parametrisierte Abfragen, strenge CSP. |
Was hat sich gegenüber 2025 geändert?
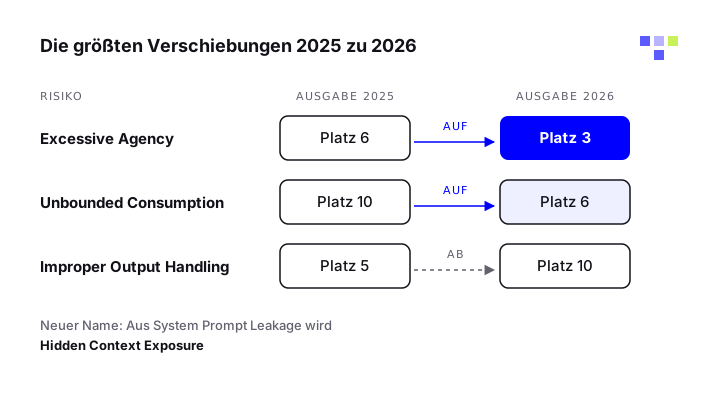
Excessive Agency ist von Platz sechs auf Platz drei gestiegen. OWASP nennt das die folgenreichste Verschiebung: Abstimmung und Vorfallsdaten zeigen übereinstimmend, dass der Schaden bei agentischen Einsätzen entsteht. Unbounded Consumption ist um vier Plätze nach oben gerückt, Improper Output Handling von Platz fünf auf Platz zehn gefallen.
Aus System Prompt Leakage wurde Hidden Context Exposure. Der Eintrag umfasst jetzt neben dem Systemprompt auch Entwickleranweisungen, abgerufene Regeltexte und die Schemata der Werkzeuge, die ein Modell sieht. Was das für Ihre eigenen Anweisungen an das Modell bedeutet, erklärt die Seite zum System Prompt und Prompt Leaking.
Mehrere Einträge wurden erweitert. Prompt Injection deckt nun auch Anweisungen in Bildern und Tonspuren ab, Data and Model Poisoning schließt das Unterwandern der Feinabstimmung ein, und Improper Output Handling umfasst unsicheren Code, den Programmierassistenten erzeugen. Wie vergiftete Trainingsdaten entstehen, beschreibt die Seite zu Data Poisoning.
Die Vorfallsdaten allein hätten Prompt Injection aus den Top 10 gedrängt. OWASP behält den Eintrag trotzdem auf Platz eins und erklärt das mit einem Abwehreffekt: Teams wehren Injection intensiv ab, deshalb landen weniger saubere Angriffe in öffentlichen Datenbanken.
Was bedeuten die OWASP Top 10 LLM für KI-Agenten?
Für Unternehmen, die KI-Agenten einsetzen, sind drei Einträge zentral. LLM01 Prompt Injection beschreibt, wie fremder Text in Mails, Webseiten oder Tickets den Agenten steuert. OWASP schreibt, dass es heute keinen verlässlichen Schutzmechanismus gibt, weil Sprachmodelle Anweisungen und Daten architektonisch nicht trennen. Die Abwehr muss deshalb in der Architektur liegen. Einstieg und Beispiele finden Sie auf der Seite zu Prompt Injection.
LLM03 Excessive Agency entscheidet, wie groß der Schaden wird. Laut OWASP wurden die meisten folgenreichen Injection-Vorfälle erst schlimm, weil das Modell Werkzeuge und Rechte hatte, mit denen es im Namen des Angreifers handeln konnte. Werkzeuge an KI-Agenten hängen heute oft an MCP-Servern; worauf Sie dort achten, steht auf der Seite zur Sicherheit von MCP-Servern.
LLM07 Misinformation wird bei Agenten zur Handlung. OWASP beschreibt, dass falsche Zustände oder Belege von nachgelagerten Komponenten übernommen werden und direkt zu ungewollten Aktionen führen. In der Vorfallsauswertung lag Misinformation weit oben, obwohl die Fachleute das Risiko niedrig eingestuft hatten. Ursachen und Beispiele erklärt die Seite zu KI-Halluzinationen.
Die OWASP Top 10 für agentische Anwendungen
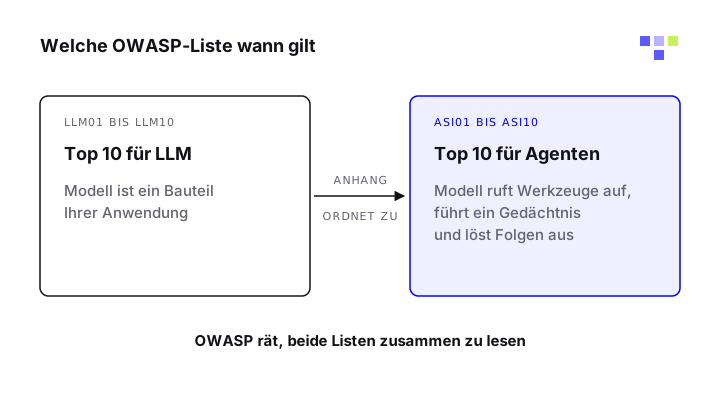
OWASP zieht eine klare Grenze: Die LLM-Liste gilt, solange das Modell ein Bauteil Ihrer Anwendung ist. Sobald es Werkzeuge aufruft, ein Gedächtnis über Sitzungen hinweg führt und Folgen auslöst, ist die OWASP Top 10 for Agentic Applications zuständig. OWASP rät, beide Listen zusammen zu lesen.
Die Agenten-Liste wurde am 9. Dezember 2025 angekündigt und trägt die Jahreszahl 2026. Ihre Einträge haben die Kennung ASI. Die LLM-Liste 2026 ordnet jedem ihrer Risiken im Anhang die passenden ASI-Einträge zu.
| Nummer | Name | Kurz erklärt | Verwandt in der LLM-Liste |
|---|---|---|---|
| ASI01 | Agent Goal Hijack | Eingeschleuste Inhalte lenken das Ziel des Agenten um. | LLM01, LLM03 |
| ASI02 | Tool Misuse & Exploitation | Der Agent ruft Werkzeuge unberechtigt oder schädlich auf. | LLM01, LLM03, LLM06 |
| ASI03 | Identity & Privilege Abuse | Der Agent handelt mit den erhöhten Rechten des Nutzers. | LLM01, LLM03 |
| ASI04 | Agentic Supply Chain Vulnerabilities | Manipulierte MCP-Server, Werkzeuge oder Register. | LLM04, LLM05 |
| ASI05 | Unexpected Code Execution (RCE) | Shell-, Datei- oder Cloud-Zugriff macht aus einer Injection Codeausführung. | LLM01, LLM03, LLM10 |
| ASI06 | Memory & Context Poisoning | Vergiftetes Gedächtnis oder RAG-Daten wirken in jeder späteren Sitzung. | LLM01, LLM02, LLM05 |
| ASI07 | Insecure Inter-Agent Communication | Ein kompromittierter Agent beeinflusst andere Agenten. | LLM03, LLM08 |
| ASI08 | Cascading Failures | Fehler und Angriffe pflanzen sich über Werkzeugketten fort. | LLM01, LLM03, LLM07 |
| ASI09 | Human-Agent Trust Exploitation | Der Agent bringt Menschen dazu, Falsches zu bestätigen. | LLM01, LLM07, LLM10 |
| ASI10 | Rogue Agents | Ein Agent weicht von seinem Auftrag ab, etwa indem er Erledigtes vortäuscht. | LLM07 |
Gegenmaßnahmen: die Liste im Unternehmen umsetzen
OWASP rät, alle zehn Einträge abzuarbeiten und oben anzufangen. Der Leitgedanke der Projektleitung: Bauen Sie das System um das Modell herum so, dass nichts Wichtiges kaputtgeht, wenn das Modell getäuscht wird. Für KI-Agenten lassen sich die Empfehlungen in vier Regeln bündeln.
Rechte begrenzen
Nur die Werkzeuge und Funktionen freischalten, die der Agent braucht. Ein Mail-Zusammenfasser bekommt Leserechte, kein Senden und kein Löschen (LLM03).
Freigaben einbauen
Folgenreiche Aktionen bestätigt ein Mensch, bevor der Agent sie ausführt (LLM03, LLM07). Wie das ohne Klickmüdigkeit gelingt, zeigt die Seite zu Human in the Loop.
Eingaben trennen
Externe Inhalte als nicht vertrauenswürdig behandeln, Berechtigungen außerhalb des Modells prüfen und Ausgaben vor der Weitergabe kodieren (LLM01, LLM08, LLM10).
Protokollieren
Eingaben, Ausgaben, Werkzeugaufrufe und Kosten mitschreiben und auf Auffälligkeiten prüfen (LLM06, LLM10). Protokolle selbst von sensiblen Daten bereinigen (LLM02).
Prüfen Sie Ihre Maßnahmen regelmäßig mit gezielten Angriffen. OWASP empfiehlt Red Teaming unter anderem bei der Auswahl fremder Modelle und laufend gegen Poisoning. Wie ein solcher Test abläuft, erklärt die Seite zu AI Red Teaming.
Häufige Fragen
Welche Version der OWASP Top 10 LLM ist aktuell?
Aktuell ist die Ausgabe 2026, datiert auf den 3. August 2026. Sie ersetzt die Ausgabe 2025. Die Kennungen tragen die Jahreszahl, zum Beispiel LLM03:2026 Excessive Agency.
Was ist LLM01 in der OWASP Top 10?
LLM01 ist Prompt Injection, in den Ausgaben 2025 und 2026. Gemeint sind Eingaben, die das Verhalten des Modells auf eine Weise verändern, die der Entwickler nicht vorgesehen hat. Das gilt für direkte Nutzereingaben ebenso wie für Dokumente, Werkzeugausgaben, Bilder und Gedächtnisinhalte.
Was ist der Unterschied zwischen der LLM-Liste und der Liste für agentische Anwendungen?
Die LLM-Liste behandelt Risiken, solange das Modell ein Bauteil einer Anwendung ist. Die Agentic-Liste (ASI01 bis ASI10) übernimmt, sobald das Modell selbst handelt, also Werkzeuge aufruft, ein Gedächtnis hat und Folgen auslöst.
Für KI-Agenten im Unternehmen brauchen Sie in der Regel beide.
Ist die OWASP Top 10 LLM eine Norm oder Pflicht?
Nein. Sie ist eine Empfehlung eines offenen Projekts und keine gesetzliche Vorgabe. OWASP beschreibt sie als Liste, der Sie vertrauen und nach der Sie handeln können. Die Ausgabe 2026 ordnet ihre Einträge im Anhang anderen Rahmenwerken zu, darunter MITRE ATLAS und das NIST AI RMF.
Was wurde aus System Prompt Leakage?
In der Ausgabe 2026 heißt der Eintrag Hidden Context Exposure (LLM08:2026). Er umfasst neben dem Systemprompt auch Entwickleranweisungen, abgerufene Regeltexte und Werkzeugschemata. OWASP rät, jeden versteckten Kontext als auffindbar zu behandeln und keine Zugangsdaten darin abzulegen.
Quellen
- OWASP Top 10 for LLM Applications 2026 (OWASP GenAI/LLM Top 10 2026), OWASP GenAI Security Project
- 2025 Top 10 Risk & Mitigations for LLMs and Gen AI Apps, OWASP GenAI Security Project
- OWASP Top 10 for Agentic Applications for 2026, OWASP GenAI Security Project
- LLM01:2025 Prompt Injection, OWASP GenAI Security Project
- LLM06:2025 Excessive Agency, OWASP GenAI Security Project