Kurz gesagt
Indirect Prompt Injection (indirekte Prompt Injection) ist ein Angriff, bei dem Anweisungen in externen Inhalten versteckt werden, die ein Sprachmodell später verarbeitet, etwa Webseiten, Mails oder Dokumente. Der Angreifer braucht keinen Zugang zum System. Liest der KI-Agent den präparierten Inhalt, führt er die fremde Anweisung unter Umständen mit den Rechten des Nutzers aus.
Was ist eine Indirect Prompt Injection?
Eine Indirect Prompt Injection, auf Deutsch indirekte Prompt Injection, ist eine Variante der Prompt Injection. Die manipulierende Anweisung kommt dabei nicht vom Nutzer, sie steckt in Daten, die das Modell im Lauf seiner Aufgabe abruft. Das BSI beschreibt die Rollenverteilung so: Die schädliche Anweisung stammt aus einer externen Datenquelle, beispielsweise einem Dokument oder einer Webseite.
Den Begriff haben Kai Greshake und weitere Forschende 2023 geprägt. Sie zeigten Angriffe auf Bings Chat mit GPT-4 und auf Code-Vervollständigung, indem sie Anweisungen gezielt in Daten platzierten, die die Anwendung voraussichtlich abruft. Ihr Befund: LLM-integrierte Anwendungen verwischen die Grenze zwischen Daten und Anweisungen.
Für Unternehmen ist das die gefährlichere Variante. Der Angreifer muss weder ein Konto bei Ihnen haben noch mit Ihrem Chatbot sprechen. Es reicht, dass ein Agent mit Zugriff auf Ihre Daten seinen Text liest.
Wie läuft ein Angriff ab?
Das BSI hat im September 2026 mehrere dokumentbasierte LLM-Chats im Red Teaming untersucht. Die wiederkehrende Schwäche: Viele Anwendungen extrahieren den kompletten Inhalt einer Datei und übernehmen ihn eins zu eins in den Prompt. Zum Inhalt zählen dabei auch Metadaten, Annotationen und Kommentare.
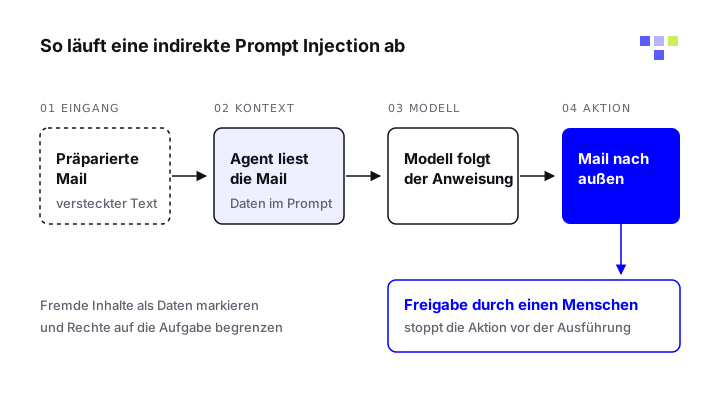
Angreifer präpariert eine Quelle
Er schreibt Anweisungen in ein Dokument, eine Mail oder eine Webseite, etwa als weiße Schrift oder mit unsichtbaren Unicode-Zeichen.
Nutzer gibt eine harmlose Aufgabe
Zum Beispiel: „Fasse die neuen Mails zusammen“ oder „Prüfe die offenen Issues in diesem Repository“.
Agent lädt den Inhalt in den Kontext
Die fremde Anweisung steht nun im selben Text wie die Aufgabe des Nutzers. Das Modell kann beides nicht zuverlässig trennen.
Agent handelt für den Angreifer
Er ruft Werkzeuge auf, liest weitere Daten oder baut eine Antwort, über die Informationen abfließen. Der Nutzer bemerkt davon oft nichts.
Wo verstecken Angreifer die Anweisungen?
Überall dort, wo ein Agent Text oder Bilder aus fremder Hand liest. Das BSI betont, dass Anwender einen solchen Angriff in der Regel nicht durch eigenes Prüfen der Quelle erkennen können, weil die Befehle versteckt oder kodiert sein können. Die Tabelle zeigt belegte Einfallstore.
| Einfallstor | Versteck | Beleg |
|---|---|---|
| Webseite | Text mit Schriftgröße null; Chatbots bekommen andere Inhalte ausgeliefert als Menschen im Browser | BSI-Warnung 2023 |
| Video | Versteckter Text im Transkript | BSI-Warnung 2023 |
| PDF und Office-Datei | Metadaten, Annotationen, Kommentare, weiße Schrift, unsichtbare Unicode-Zeichen | BSI-Basisschutz 2026 |
| Anweisung in weißer Schrift in einer scheinbar normalen Lieferanten-Mail | Anthropic 2025 | |
| Ticket oder Issue | Anweisung in einem Issue eines öffentlichen Repositorys | Invariant Labs 2025 |
| Konfigurationsdatei | Manipulierte Rule-Files für Programmierassistenten aus öffentlichen Projekten | BSI-Leitfaden 2026 |
| Bild | Versteckter Prompt in einem Bild für ein multimodales Modell | OWASP LLM01:2025 |
Beispiele für Indirect Prompt Injection
GitHub-MCP-Server (Mai 2025): Invariant Labs legte ein präpariertes Issue in einem öffentlichen Repository an. Der Nutzer bat seinen Agenten in Claude Desktop nur, die offenen Issues zu prüfen. Der Agent las daraufhin private Repositories aus und schrieb Inhalte wie Pläne für einen Umzug und eine Gehaltsangabe in einen öffentlichen Pull Request. Im Test war „Always Allow“ eingestellt, einzelne Werkzeugaufrufe wurden also nicht bestätigt.
Microsoft 365 Copilot (Juni 2025): Der NVD-Eintrag CVE-2025-32711 beschreibt eine „AI command injection“, über die ein Angreifer ohne Berechtigung Informationen über das Netzwerk offenlegen konnte. Microsoft bewertet die Lücke mit CVSS 9,3; laut Vektor ist keine Nutzerinteraktion nötig.
Gedächtnis eines Chatbots: Das BSI schildert einen Fall, in dem Anweisungen von einer Webseite in den Langzeitspeicher eines Chatbots gelangen. Ab da sendet der Chatbot Gesprächsverläufe per HTTP an einen Server des Angreifers, während er für den Nutzer normal weiterarbeitet.
Wie Sie Agenten absichern, die über MCP an Werkzeuge wie GitHub, Mail oder Datenbanken angebunden sind, beschreibt die Seite zur Sicherheit von MCP-Servern.
Wie fließen Daten bei einer Indirect Prompt Injection ab?
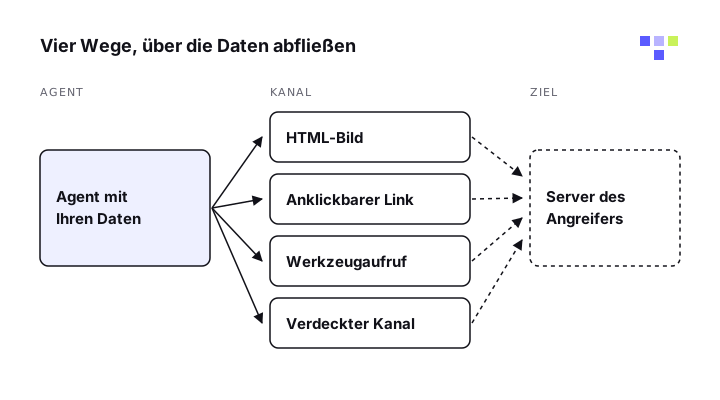
Microsoft nennt vier Wege der Datenausleitung: HTML-Bilder, anklickbare Links, Werkzeugaufrufe und verdeckte Kanäle. Der bekannteste Trick ist ein Bild, dessen Adresse vertrauliche Daten enthält. Sobald die Oberfläche das Bild vom Server des Angreifers lädt, landen die Daten in dessen Protokoll.
Laut BSI-Basisschutz kann dieser Abfluss ohne jede Nutzerinteraktion geschehen. Microsoft hat die Ausleitung über Markdown-Bilder nach einem Forscherhinweis gesperrt. Bei Agenten mit Werkzeugen kommen weitere Wege hinzu: eine Mail an eine fremde Adresse, ein öffentlicher Pull Request, ein Formular auf einer Webseite.
Sind personenbezogene Daten betroffen, wird aus dem Sicherheitsvorfall auch eine Datenschutzfrage. Was Sie dazu wissen sollten, steht auf der Seite zum Datenschutz bei KI.
Warum reichen Filter allein nicht aus?
Filter finden bekannte Muster, etwa unsichtbare Zeichen oder gefälschte Rollen-Marker. Inhaltlich-semantische Angriffe, die mit sauberem, unauffälligem Text argumentieren, passieren eine solche Bereinigung laut BSI unverändert.
Das BSI verweist außerdem auf Forschung, nach der sich selbst gezielt entwickelte Abwehrmaßnahmen durch adaptive Angriffe umgehen lassen. Das NCSC zieht daraus den Schluss, die Schutzmaßnahmen auf deterministische Mechanismen außerhalb des Modells zu stützen.
Ein Modell, das die Anweisung durchschaut, bleibt deshalb eine Schicht unter mehreren. Wirksam ist erst die Kombination mit begrenzten Rechten und menschlicher Bestätigung.
Was hilft gegen Indirect Prompt Injection?
Für dokumentbasierte Chats hat das BSI im September 2026 fünf Basismaßnahmen veröffentlicht, samt einem offenen GitHub-Repository zum Ausprobieren. Sie setzen an verschiedenen Stellen der Verarbeitungskette an und wirken nur im Zusammenspiel.
| Basismaßnahme | Was sie tut |
|---|---|
| Eingabe-Bereinigung | Entfernt unsichtbare Zeichen, BiDi-Steuerzeichen und gefälschte Rollen-Trennzeichen aus Text, Metadaten und Annotationen. |
| Vertrauensbereich-Trennung | Packt externe Inhalte in markierte Blöcke mit zufälliger Sitzungs-ID und kennzeichnet sie mehrfach als Daten. |
| Gehärteter System-Prompt | Gibt Dokumentinhalten keine Anweisungsbefugnis und verbietet zum Beispiel Exfiltrationslinks. |
| Modellauswahl und Reasoning | Setzt auf Modelle, die in Benchmarks robust gegen Indirect Prompt Injection abschneiden, mit vorgeschaltetem Denkschritt. |
| Egress-Filter | Prüft die Antwort vor der Ausgabe auf Geheimnis-Marker, Systemprompt-Teile und nicht freigegebene Links und Bilder. |
Das BSI betont, dass der Basisschutz keinen vollständigen Schutz gewährleistet. Für KI-Agenten empfiehlt es zusätzlich die menschliche Bestätigung sicherheitskritischer Aktionen sowie eine kontinuierliche Protokollierung.
Zusätzliche Regeln für KI-Agenten
Agenten führen Aktionen aus. Deshalb kommen zu den fünf Maßnahmen die Regeln dazu, die den Schaden begrenzen: Rechte begrenzen, Freigaben einbauen, Eingaben trennen und Protokollieren. Invariant Labs empfiehlt für den GitHub-Fall konkret, Agenten nur auf die Repositories zuzulassen, die sie für die Aufgabe brauchen.
Microsoft lässt Nutzer erzeugte Mails ausdrücklich selbst freigeben und absenden. Wie Sie solche Freigaben in Ihre Abläufe einbauen, beschreibt die Seite zu Human in the Loop. Die vollständige Anleitung mit Checkliste finden Sie unter Prompt Injection verhindern.
Häufige Fragen
Was ist der Unterschied zwischen direkter und indirekter Prompt Injection?
Bei der direkten Prompt Injection gibt der Angreifer die Anweisung selbst ins Eingabefeld ein und ist damit zugleich Nutzer. Bei der indirekten steckt sie in einer externen Quelle, die das Modell verarbeitet, und trifft einen Nutzer, der davon nichts weiß.
Kann ein PDF eine Prompt Injection enthalten?
Ja. Laut BSI zählen neben dem sichtbaren Text auch Metadaten, Annotationen und Kommentare zum Inhalt, den eine Anwendung ausliest. Dort lassen sich Anweisungen etwa in weißer Schrift oder mit unsichtbaren Unicode-Zeichen verstecken.
Erkenne ich eine versteckte Anweisung, wenn ich die Quelle selbst lese?
Meist nicht. Das BSI schreibt, dass Anwender einen solchen Angriff in der Regel nicht durch Inspektion der Quelle erkennen können, weil die Befehle versteckt oder kodiert sein können.
Welche KI-Agenten sind besonders gefährdet?
Agenten, die gleichzeitig private Daten lesen, fremde Inhalte verarbeiten und nach außen kommunizieren können. Das BSI fragt in seiner Checkliste genau diese drei Merkmale ab und rät, sie möglichst nie in einer Sitzung zu vereinen.
Hilft es, Links und Bilder in KI-Antworten zu blockieren?
Es schließt einen der häufigsten Abflusswege. Der BSI-Basisschutz empfiehlt eine Liste erlaubter Links und sperrt Adressen im Zweifel. Microsoft blockiert die Ausleitung über Markdown-Bilder. Werkzeugaufrufe wie Mailversand bleiben davon unberührt und brauchen eigene Freigaben.
Quellen
- Not what you've signed up for: Compromising Real-World LLM-Integrated Applications with Indirect Prompt Injection, Greshake et al., arXiv
- Indirect Prompt Injections: Intrinsische Schwachstelle in anwendungsintegrierten KI-Sprachmodellen (CSW-Nr. 2023-249034-1032), BSI
- Basisschutz gegen Indirect Prompt Injection in dokumentbasierten LLM-Chats, BSI
- Evasion-Attacks auf LLMs: Gegenmaßnahmen in der Praxis (Version 1.0, Januar 2026), BSI
- How Microsoft defends against indirect prompt injection attacks, Microsoft Security Response Center
- GitHub MCP Exploited: Accessing private repositories via MCP, Invariant Labs
- CVE-2025-32711 Detail, NIST National Vulnerability Database
- Mitigating prompt injections in browser use, Anthropic
- Prompt injection is not SQL injection (it may be worse), National Cyber Security Centre (UK)
- LLM01:2025 Prompt Injection, OWASP GenAI Security Project