Kurz gesagt
Die wichtigsten Begriffe zur Sicherheit von KI-Agenten sind Prompt Injection (eingeschleuste Anweisungen), Tool Poisoning (manipulierte Werkzeugbeschreibungen in MCP-Servern), die Lethal Trifecta (private Daten, fremde Inhalte und Weg nach außen in einem Agenten), Least Privilege (minimale Rechte) und Human in the Loop (menschliche Freigabe kritischer Aktionen). Rechtlich zentral sind Betreiber, Anbieter und Hochrisiko-KI nach KI-Verordnung.
A bis D
| Begriff | Bedeutung |
|---|---|
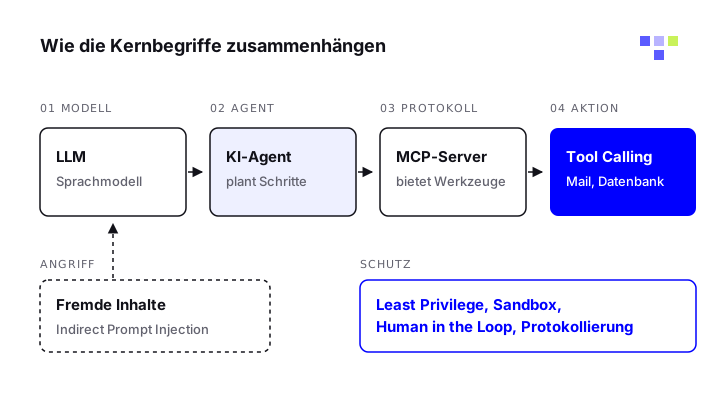
| Agent (KI-Agent) | Software, die mit einem Sprachmodell eine Aufgabe in mehreren Schritten selbst plant und dafür Werkzeuge aufruft, etwa Postfach, Browser oder Dateisystem. Aufbau und Beispiele erklärt die Seite zu KI-Agenten. |
| Agentic AI | Sammelbegriff für KI-Systeme, die eigenständig handeln statt nur zu antworten. Was dahintersteckt, zeigt die Seite zu Agentic AI. |
| Anbieter | Nach Artikel 3 Nummer 3 KI-Verordnung, wer ein KI-System oder KI-Modell entwickelt oder entwickeln lässt und unter eigenem Namen in Verkehr bringt oder in Betrieb nimmt. Die Pflichten erklärt die Seite zur KI-Verordnung. |
| Automation Bias | Zu großes Vertrauen in KI-Ausgaben, durch das Nutzer Ergebnisse ungeprüft übernehmen. Das BSI führt es als eigenes Risiko generativer KI, mehr unter KI-Halluzinationen. |
| AVV (Auftragsverarbeitungsvertrag) | Vertrag nach Artikel 28 DSGVO mit einem Dienstleister, der personenbezogene Daten im Auftrag verarbeitet, etwa einem KI-Anbieter. Grundlagen auf der Seite zu KI und Datenschutz. |
| Betreiber | Nach Artikel 3 Nummer 4 KI-Verordnung, wer ein KI-System in eigener Verantwortung verwendet, außer rein privat. Ein Unternehmen, das KI-Werkzeuge beruflich einsetzt, ist in der Regel Betreiber, siehe KI-Verordnung. |
| Coding-Agent | KI-Agent, der Code liest, schreibt und Befehle im Terminal ausführt. Wie Sie ihn mit Werkzeugen sicher verbinden, steht unter Claude Code und MCP. |
| Data Poisoning | Manipulation von Trainings- oder Feinabstimmungsdaten, damit ein Modell Hintertüren oder falsches Verhalten lernt. OWASP führt es in der Ausgabe 2026 als LLM05, Details auf der Seite zu Data Poisoning. |
| DSFA (Datenschutz-Folgenabschätzung) | Vorab-Prüfung nach Artikel 35 DSGVO, wenn eine Verarbeitung, insbesondere mit neuen Technologien, voraussichtlich ein hohes Risiko für Betroffene hat. Wann sie bei KI nötig wird, erklärt KI und Datenschutz. |
E bis H
| Begriff | Bedeutung |
|---|---|
| Egress-Filter | Prüfung der fertigen Antwort eines Modells, bevor sie den Nutzer erreicht, etwa auf Exfiltrations-Links oder Teile des System-Prompts. Das BSI nennt ihn als letzte Verteidigungslinie, siehe Prompt Injection verhindern. |
| Evasion-Angriff | BSI-Oberbegriff für Eingaben, die Verhalten oder Schutzmechanismen eines Sprachmodells zur Laufzeit umgehen, ohne die Modellparameter zu verändern. Dazu zählen Prompt Injection und Jailbreak, mehr unter BSI und KI. |
| Excessive Agency | Übermäßige Handlungsfreiheit: Ein Agent hat mehr Funktionen, Rechte oder Autonomie als nötig. OWASP führt das Risiko in der Ausgabe 2026 als LLM03, siehe OWASP Top 10 für LLM. |
| Exfiltration | Unbemerktes Ausleiten von Daten, bei KI-Agenten oft über einen Link oder ein Bild in der Antwort, das Daten an einen fremden Server überträgt. Typisch für indirekte Prompt Injection. |
| GPAI (KI-Modell mit allgemeinem Verwendungszweck) | Nach Artikel 3 Nummer 63 KI-Verordnung ein Modell, das ein breites Spektrum von Aufgaben erfüllen und in viele Anwendungen integriert werden kann, etwa ein großes Sprachmodell. Seine Anbieter haben eigene Pflichten, siehe KI-Verordnung. |
| Halluzination | Eine überzeugend formulierte, aber falsche Ausgabe eines Sprachmodells, etwa eine erfundene Quelle. Ursachen und Gegenmaßnahmen auf der Seite zu KI-Halluzinationen. |
| Hochrisiko-KI | KI-Systeme nach Artikel 6 und Anhang I oder III KI-Verordnung, etwa in Personalauswahl oder Kreditprüfung. Ihre Pflichten gelten nach der Verordnung (EU) 2026/1744 ab 2. Dezember 2027 (Anhang III) und 2. August 2028 (Anhang I), siehe KI-Verordnung. |
| Human in the Loop | Ein Mensch prüft und bestätigt kritische Aktionen eines Agenten, bevor sie ausgeführt werden. Wie man Freigaben sinnvoll gestaltet, zeigt Human in the Loop. |
I bis K
| Begriff | Bedeutung |
|---|---|
| Indirect Prompt Injection | Prompt Injection über Inhalte Dritter wie Webseiten, Mails oder Dokumente, die der Agent liest. Das BSI beschreibt sie als Ausnutzung der Fehlinterpretation von Daten als Anweisungen, siehe indirekte Prompt Injection. |
| Jailbreak | Angriff, bei dem ein Nutzer-Prompt das im Training erlernte Verhalten eines Modells verändert, meist um Sicherheitsregeln auszuhebeln. Techniken und Abwehr unter KI-Jailbreak. |
| KI-Browser | Webbrowser, in dem ein KI-Agent selbst Seiten öffnet, liest und Aktionen ausführt. Er liest dabei fremde Inhalte, wie das Beispiel ChatGPT Atlas zeigt. |
| KI-Kennzeichnungspflicht | Transparenzpflichten aus Artikel 50 KI-Verordnung, etwa die Offenlegung von Deepfakes durch Betreiber, anwendbar seit dem 2. August 2026. Einzelheiten unter KI-Kennzeichnungspflicht. |
| KI-Kompetenz | Pflicht aus Artikel 4 KI-Verordnung: Anbieter und Betreiber ergreifen Maßnahmen, um die KI-Kompetenz ihres Personals zu unterstützen. Seit der Neufassung durch die Verordnung (EU) 2026/1744 müssen sie kein bestimmtes Niveau je Person garantieren. |
| KI-Richtlinie | Interne Regel, welche KI-Werkzeuge Beschäftigte wofür und mit welchen Daten nutzen dürfen. Aufbau und Vorlage auf der Seite zur KI-Richtlinie. |
| KI-System | Nach Artikel 3 Nummer 1 KI-Verordnung ein maschinengestütztes System, das mit unterschiedlicher Autonomie arbeitet und aus Eingaben ableitet, wie es Ausgaben wie Vorhersagen, Inhalte, Empfehlungen oder Entscheidungen erzeugt. |
| KI-Verordnung | Verordnung (EU) 2024/1689, die KI-Systeme nach Risiko reguliert und Pflichten für Anbieter und Betreiber festlegt, zuletzt geändert durch die Verordnung (EU) 2026/1744. Überblick für Unternehmen unter KI-Verordnung. |
L bis O
| Begriff | Bedeutung |
|---|---|
| Least Privilege | Prinzip der minimalen Rechte: Ein Agent erhält nur die Zugriffe, die er für genau diese Aufgabe braucht. Das BSI empfiehlt, Zugriffs- und Ausführungsrechte LLM-basierter Anwendungen auf das notwendige Minimum zu beschränken, siehe Prompt Injection verhindern. |
| Lethal Trifecta | Von Simon Willison 2025 geprägter Begriff für drei Fähigkeiten, die zusammen gefährlich sind: Zugriff auf private Daten, Kontakt mit nicht vertrauenswürdigen Inhalten und ein Weg nach außen. Warum das zählt, erklärt Prompt Injection. |
| LLM (Large Language Model) | Großes Sprachmodell, das Text verarbeitet und erzeugt und die Grundlage von Chat-Assistenten und KI-Agenten bildet. Es kann laut BSI nicht sicher zwischen Anweisungen und Daten unterscheiden. |
| MCP (Model Context Protocol) | Protokoll, über das KI-Anwendungen wie Claude Code oder Visual Studio Code als Host Verbindungen zu Servern aufbauen, die Werkzeuge, Ressourcen und Prompts bereitstellen. Risiken erklärt die Seite zur Sicherheit von MCP-Servern. |
| MCP-Server | Programm, das einer KI-Anwendung über MCP Kontext und Werkzeuge liefert, lokal auf dem Rechner oder entfernt über HTTP. Wie Sie eigene Server anbinden, steht unter Claude Code und MCP. |
| OWASP Top 10 für LLM | Liste der zehn wichtigsten Sicherheitsrisiken für Anwendungen mit Sprachmodellen, aktuell in der Ausgabe 2026 mit Prompt Injection als LLM01. Alle zehn erklärt die Seite OWASP Top 10 für LLM. |
P bis R
| Begriff | Bedeutung |
|---|---|
| Prompt | Text oder Anweisung, die einem Sprachmodell übergeben wird, um eine Antwort zu erzeugen. Er setzt sich aus System-Prompt, Nutzer-Prompt und Daten zusammen. |
| Prompt Injection | Angriff, bei dem eingeschleuster Text das Verhalten eines Sprachmodells verändert, sodass es seine Vorgaben nicht mehr vollständig beachtet. Abläufe und Fälle auf der Seite zu Prompt Injection. |
| Prompt Leaking | Ein Angreifer bringt das Modell dazu, seinen vertraulichen System-Prompt preiszugeben. OWASP fasst das Risiko in der Ausgabe 2026 unter LLM08 Hidden Context Exposure, mehr unter System-Prompt. |
| Protokollierung | Aufzeichnung von Eingaben, Ausgaben und Werkzeugaufrufen eines Agenten, damit Missbrauch auffällt und Vorfälle nachvollziehbar bleiben. Eine der vier Regeln unter Prompt Injection verhindern. |
| RAG (Retrieval-Augmented Generation) | Verfahren, bei dem ein Modell vor der Antwort passende Textstellen aus eigenen Dokumenten abruft. Schwachstellen in Vektordatenbanken führt OWASP in der Ausgabe 2026 als LLM09, Datenschutzfragen behandelt KI und Datenschutz. |
| Red Teaming | Gezieltes Angreifen eines KI-Systems, um Schwachstellen vor echten Angreifern zu finden. Das BSI hat seinen Basisschutz 2026 aus Red-Teaming-Tests abgeleitet, Methoden unter AI Red Teaming. |
| Rug Pull | Ein MCP-Server ändert die Beschreibung eines Werkzeugs, nachdem der Nutzer es bereits freigegeben hat, und schleust so später schädliche Anweisungen ein. Gegenmaßnahmen unter Sicherheit von MCP-Servern. |
S bis Z
| Begriff | Bedeutung |
|---|---|
| Sandbox | Abgeschottete Umgebung, in der ein Agent Befehle ausführt, ohne auf das übrige System, Zugangsdaten oder das Netz zugreifen zu können. Ein Beispiel zeigt OpenClaw installieren. |
| Schatten-KI (Shadow AI) | KI-Werkzeuge, die Beschäftigte ohne Freigabe der IT nutzen, oft mit privaten Konten. Wie Sie sie erkennen und regeln, beschreibt Schatten-KI. |
| System-Prompt | Der Teil des Prompts vom Entwickler oder Betreiber, der Regeln für die Kommunikation zwischen Nutzer und Modell festlegt. Härtung und Schutz unter System-Prompt. |
| Tool Calling | Fähigkeit eines Modells, Werkzeuge mit Parametern aufzurufen, etwa eine Datenbankabfrage oder einen Mailversand. Erst dadurch wird aus einem Chatbot ein KI-Agent. |
| Tool Poisoning | Form der indirekten Prompt Injection, bei der schädliche Anweisungen in der Beschreibung eines MCP-Werkzeugs stecken, die das Modell liest, der Nutzer aber meist nicht sieht. Beschrieben von Invariant Labs, mehr unter Sicherheit von MCP-Servern. |
| Vertrauensbereich-Trennung | Fremde Inhalte werden im Prompt als nicht vertrauenswürdig markiert und von Anweisungen getrennt. Eine der fünf Basismaßnahmen des BSI, siehe Prompt Injection verhindern. |
| Vektor- und Embedding-Schwächen | Risiken in Vektordatenbanken von RAG-Systemen, etwa Zugriff auf fremde Dokumente oder eingeschleuste Inhalte. OWASP führt sie in der Ausgabe 2026 als LLM09, siehe OWASP Top 10 für LLM. |
Häufige Fragen
Was ist ein KI-Agent einfach erklärt?
Ein KI-Agent ist ein Sprachmodell, das selbst Werkzeuge bedient: Er liest Mails, öffnet Webseiten, ändert Dateien oder ruft Programme auf. Dadurch kann er Aufgaben in mehreren Schritten erledigen, aber auch mit den Rechten seines Nutzers Fehler machen.
Was ist der Unterschied zwischen Prompt Injection und Jailbreak?
Das BSI grenzt so ab: Bei Prompt Injection führt eine Eingabe dazu, dass das Modell seine Vorgaben aus dem System-Prompt nicht mehr vollständig beachtet. Bei einem Jailbreak verändert die Eingabe das im Training erlernte Verhalten, etwa Sicherheitsregeln. Beide Varianten gibt es auch indirekt über Inhalte Dritter.
Was unterscheidet Anbieter und Betreiber in der KI-Verordnung?
Anbieter entwickeln ein KI-System oder Modell und bringen es unter eigenem Namen auf den Markt. Betreiber verwenden ein KI-System in eigener Verantwortung, im Unternehmen also meist die Firma, die ein Werkzeug einsetzt. Wer ein System unter eigenem Namen weitergibt, kann selbst zum Anbieter werden. Diese Angaben sind keine Rechtsberatung.
Was bedeutet Lethal Trifecta?
Der Begriff beschreibt drei Fähigkeiten eines Agenten, die zusammen einen Datenabfluss ermöglichen: Zugriff auf private Daten, Kontakt mit nicht vertrauenswürdigen Inhalten und ein Weg nach außen. Fehlt eine davon, hat ein Angreifer keinen einfachen Weg mehr, Daten über den Agenten abzuziehen.
Quellen
- Evasion-Attacks auf LLMs: Gegenmaßnahmen in der Praxis (15.01.2026), BSI
- Basisschutz gegen Indirect Prompt Injection in dokumentbasierten LLM-Chats, BSI
- OWASP Top 10 for LLM Applications 2025, OWASP GenAI Security Project
- Architecture overview, Model Context Protocol
- MCP Security Notification: Tool Poisoning Attacks, Invariant Labs
- The lethal trifecta for AI agents: private data, untrusted content, and external communication, Simon Willison
- Verordnung (EU) 2024/1689 (KI-Verordnung), EUR-Lex
- Verordnung (EU) 2026/1744 (Digital-Omnibus zur KI), EUR-Lex